OpenAI 的 Aura 能悄悄屏蔽你的网站,而服务器日志毫无痕迹:AI 可见性的上游黑盒
发布时间:2026-11-03 人气:13次
关于“如何被 AI 搜索看见”,绝大多数讨论还停留在表层:用结构化内容争取引用、给实体下清晰定义、在 robots.txt 里授予权限。但有一道更基础的墙,发生在所有这些标准动作之前,而且数字出版商几乎从不讨论它——你的网站可能被 AI 平台在“上游”悄悄屏蔽,而你的服务器日志连一次请求都不会记录。
这篇文章要拆解的,是 OpenAI 内部一个名为 Aura 的中心化安全检查系统。它能在你完全不知情、且 robots.txt 一切正常的情况下,让 ChatGPT 的浏览工具和 Codex 的 Browser Use 彻底拒绝打开你的网站。对依赖 AI 流量和 AI 引用的品牌来说,这是一个比“没被引用”更隐蔽、也更危险的问题。
一、比引用更早的一道墙:Aura 是什么
OpenAI 公开列出了多种网络爬虫,包括用于训练模型的 GPTBot、用于搜索功能的 OAI-SearchBot,以及代表用户直接请求的 ChatGPT-User。它们公布 IP、遵循标准网络规则,属于“公开、可预期”的一类。
但 Aura 是另一回事。它是一个中心化的安全检查系统,决定 OpenAI 的网页浏览工具能否连接某个网站。一旦网站被该系统标记,Codex 的 Browser Use、ChatGPT 的实时搜索等工具就会完全拒绝打开网站,并彻底忽略用户的本地设置和 robots.txt 规则。OpenAI 系统及其代码库把它称为 Aura,注意不要与 Atlas 曾使用过的同名代号混淆。
最关键的信息在流量层:OpenAI 会向 chatgpt.com/backend-api/aura/site_status 发出状态检查。当网站被标记为屏蔽时,这一决定会在本地缓存 24 小时,而网站所有者没有清晰渠道申诉或提问。换句话说,你甚至可能永远不知道自己被屏蔽了。
二、它是什么、不是什么:爬虫与实时浏览工具的差别
要正确判断“智能体为什么打不开我的页面”,必须先分清两类抓取。
一类是普通自动数据采集器,比如 GPTBot、OAI-SearchBot,它们按计划爬取、遵循 robots.txt,行为可预期,日志里能看到。另一类是实时浏览工具,比如 ChatGPT 实时搜索、Codex Browser Use,它们是在用户提出请求时即时打开网页的。Aura 管的是后者——它是独立于公开爬虫的一道额外护栏,决定自主工具能否访问特定链接。
官方帮助页面称,智能体可能因安全、安保和合规原因,被一份全球屏蔽名单阻止访问某些网站;与非法活动关联的网站会被禁止浏览,这本身是一项合理的防护。但问题在于,OpenAI 没有公开解释这套系统的技术设置,也没有给网站所有者提供自助查询或申诉入口。
三、它默认拒绝,而且凌驾于你的设置之上
一个让企业尤其头疼的细节是:即使企业管理员在自己的系统里设置了自定义放行规则,OpenAI 的内部决定仍会覆盖这些规则并阻止页面加载。OpenAI 工程师曾表示,状态检查发生网络故障时默认允许访问;但明确的网站屏蔽依然严格生效。
这意味着,Aura 的屏蔽不是“建议你别访问”,而是“在平台层强制拒绝”。底层模型还会被告知不要尝试任何备用方案或其他加载方法——规则被严格执行。对一家公司来说,最尴尬的局面就是:你明明在自家系统里写了“允许”,ChatGPT 却连试都不试。
四、我们不知道什么会让域名进名单
更令人不安的是触发机制的不透明。由于状态 API 请求会把聊天详情和网页链接一起发送,一些研究人员怀疑,某些提示历史可能意外触发整站屏蔽。无论真实原因是什么,包括知名媒体品牌在内的可信商业平台,都在遭遇无法解释的屏蔽。
这意味着“我是一家正常公司”并不能保证安全。完全正常、历史悠久的网站,也可能因为平台一侧的分类错误而突然从所有智能体浏览中消失。而一旦消失,你既看不到原因,也没有正式通道去问“为什么”。
五、证据:一家 ChatGPT 打不开的知名出版商
文章作者为一家国际媒体出版商提供咨询,这个案例把抽象风险变成了具体画面。该出版商发布官方新闻和杂志内容,保持着完全开放的 robots.txt,也支持 OpenAI 工具,却从 2026 年 5 月起反复遭遇 ChatGPT 无法加载其网页的问题——只返回一般错误信息,却从未真正尝试连接。
一系列对照测试排除了“网站自身设置错误”的可能:同会话里,两家直接竞争的数字报纸与杂志可以正常加载;一个使用相同技术但托管在另一域名的第三方页面也可以正常加载(相同技术、不同主机名,就没有屏蔽);Chrome 权限设为“始终允许”并添加明确条目,页面仍被阻止;数周后,测试的五类 URL(主站、子域、文章页)依然被阻止。
与此同时,网站流量统计显示,过去 30 天 OpenAI 训练爬虫仅成功连接约 5,000 次,而 Google 约 477,000 次、Anthropic 约 564,000 次。这说明,即使智能体浏览被完全阻断,整体爬取访问实际上也非常有限——但“可见”与“可被实时浏览”是两件事,后者被掐断,对依赖实时信息的品牌是致命的。
六、如何判断你是否被误屏蔽
如果你怀疑自己遭遇了上游屏蔽,可以按一套分步流程在联系支持前收集证据:
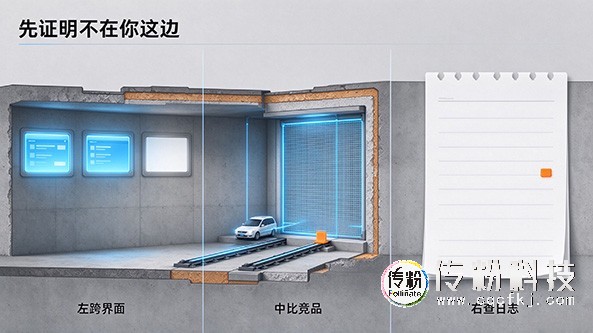
跨界面测试相同 URL:在 ChatGPT 实时抓取里要求打开指定 URL,并尝试云浏览器、Codex Browser Use 与 Computer Use,站点安全屏蔽通常会在多个界面出现。在同一会话运行对照:立刻打开两三家竞争对手网站,若它们能加载而你的不能,可排除一般性服务故障。检查 CDN 和服务器日志是否完全没有请求——Aura 在请求离开 OpenAI 前就阻止连接,失败时刻你的日志里不会留下任何入站请求,这与网站一侧的屏蔽(会留下 403、验证页或 WAF 事件)截然不同。检查爬虫分析:若 GPTBot、OAI-SearchBot 或 ChatGPT-User 能获得 2xx 响应,而智能体仍被拒绝,问题就在上游。测试边界:尝试子域、深层文章 URL,以及托管在另一域名但用你方技术的第三方页面。记录精确错误文案并截图留证。最后排除自身技术栈:robots.txt、WAF、机器人管理规则、地域与速率限制,确认屏蔽确实不在你这边。
七、你能做什么:证据包、工单与三问
由于没有自助页面能修复 Aura 分类,纠正误屏蔽需要完整证据和持续跟进。建议建立证据包:带时间戳的错误截图、竞品对照结果、没有入站请求的日志摘录、显示 OpenAI 爬虫成功访问的分析数据,以及 robots.txt。提交支持工单并保留工单号;若多个产品受影响,应在每个工单中说明并要求关联。
向支持方提出三个具体问题:第一,该域名是否有站点安全分类,若有,原因是什么?第二,它影响哪些界面(实时抓取、OAI-SearchBot 搜索、云浏览器、Codex)?第三,申请复核的流程是什么?广告主、出版商合作伙伴与企业客户还应通过客户经理渠道反映。千万不要尝试绕过——OpenAI 使用政策禁止规避安全缓解措施,试图偷偷绕过一个分类,是最快把误报变成合理屏蔽的方法。
八、商业影响:即便做了最好的 GEO,也可能看不到结果
这件事最该让品牌警醒的地方在于:随着用户转向会搜索网页并直接完成任务的自主智能体,被屏蔽的网站会被自动排除在选项之外。当智能体无法打开你的网站获取实时信息或执行操作时,它会直接转向另一个来源。
更隐蔽的是,由于 Aura 在请求离开 OpenAI 前就阻止连接,网页服务器日志不会记录失败访问。除非团队专门测试智能体操作,否则潜在用户访问的重大损失会完全隐藏在分析系统之外。文章里那家出版商的竞品,能在完全相同的聊天会话中顺利打开——只要智能体需要实时网页访问,能访问的竞品就默认赢得流量。对依赖信任和准确性的成熟品牌,还有另一重风险:ChatGPT 会根据二手来源、论坛帖子和过时新闻构建答案,而非你的主站。
一个尤其讽刺的场景是:付费广告主可能一边为在 ChatGPT 中展示付费,一边又完全无法让它的浏览智能体打开自己的链接。
九、我的观点:AI 搜索平台需要自己的“站长工具”
OpenAI 阻止访问真正危险的网站以防范提示注入和网络欺诈,完全合理;在单个用户选择之上建立强大的安全层,也是网页浏览 AI 工具应有的保护。但任何能悄悄屏蔽真实商业公司的系统,都需要配套的管理工具:清楚的错误信息和有文档的复核流程。搜索引擎当年建设了站长工具来处理人工惩罚,AI 搜索平台也必须为网站所有者创建清晰的管理流程。
在这些工具出现之前,负责组织搜索可见度的人,必须把“智能体访问检查”纳入常规 AI 搜索审计。确保网站能被爬取已不再足够——网站还必须能被自主智能体打开。
十、给品牌的三条预防清单
把上游黑盒风险纳入日常,不需要等 OpenAI 开放申诉通道。三条最低可行动作:其一,每周用 ChatGPT 实时抓取与 Codex Browser Use 测试一批关键 URL,记录能否打开、错误文案与时间点,形成自己的“智能体可达性”基线。其二,维护干净的爬虫访问记录——确保 GPTBot、OAI-SearchBot 等获得 2xx,并在 robots.txt 与 WAF 设置清晰,这样一旦被屏蔽,能立刻证明问题不在己方。其三,把“可被自主智能体打开”与“被 AI 准确引用”作为两个独立指标分别监测,因为 Aura 类屏蔽会让你连被引用的机会都没有。
常见问题
Aura 和公开的 GPTBot 是一回事吗?
不是。GPTBot 等是公开、遵循 robots.txt 的爬虫,日志可见;Aura 是中心化的安全检查,决定实时浏览工具能否打开网站,可无视本地设置与 robots.txt,且不记录到你方日志。
我的 robots.txt 是开放的,为什么还会被屏蔽?
Aura 的屏蔽发生在 OpenAI 基础设施内部,与你的 robots.txt 无关。文章中的出版商保持完全开放规则仍被拦截,证明问题在平台一侧。
怎么判断是网站自己挡的还是上游挡的?
核心看日志:网站一侧的屏蔽会留下 403、验证页或 WAF 事件;Aura 屏蔽在失败时刻不会在你的日志里留下任何入站请求。再配合跨界面、跨竞品对照测试即可确认。
被误屏蔽能不能自己绕过?
不建议也不允许。OpenAI 使用政策禁止规避安全缓解措施,试图绕过会把误报变成合理屏蔽,反而更难解除。
品牌现在能做什么预防性动作?
把智能体访问检查纳入常规 AI 搜索审计:定期用 ChatGPT 实时抓取、Codex Browser Use 测试关键 URL,记录对照结果;同时维护干净的爬虫访问记录,以便出问题时快速证明屏蔽不在己方。
关于本文
本文揭示的是 AI 可见性里最隐蔽的一层风险:即便内容、结构与权限都正确,品牌仍可能因平台内部的安全分类而被“上游”屏蔽。重庆传粉科技在为企业做 GEO 与 ACBP 服务时,把“可被机器准确读取”和“可被自主智能体打开”视为两道不同的关卡。传粉的全栈 AI 优化引擎不仅帮助品牌整理企业知识图谱、构建可被引用的单一真相层,也把智能体访问与跨平台可见性纳入持续监测范围,提前发现“被引用却打不开”“被错误分类”这类黑盒问题。需要说明,Aura 的具体机制由 OpenAI 控制、对外不透明,任何企业都无法单凭自身完全规避,传粉的服务旨在把这类风险纳入可观测、可应对的运营体系。
数据来源与边界声明
· 关于 OpenAI Aura 中心化安全检查、site_status 接口、24 小时本地缓存及默认拒绝行为的描述,来源:Search Engine Journal 报道及作者技术调查。
· 案例出版商现象:2026 年 5 月起 ChatGPT 反复无法加载其网页;对照测试(竞品可加载、同技术异域名可加载、Chrome 始终允许仍被阻止、五类 URL 持续被阻止);OpenAI 训练爬虫约 5,000 次对 Google 约 477,000 次、Anthropic 约 564,000 次,为文章披露数据。
· OpenAI 官方帮助页面关于全球屏蔽名单、安全/安保/合规理由的表述,以及使用政策中关于禁止规避安全缓解措施的内容。
· 文中“商业影响”“我的观点”等分析为作者基于上述事实的评论与推论,非 OpenAI 官方立场,也不构成对 OpenAI 系统的确定性结论。
· 重庆传粉科技相关服务描述仅作背景说明,非本文研究结论的一部分。
 客服1
